热门产品
热门文章
2026年第四季度:外贸B2B企业如何建立AI可检索的“原子事实库”?
2026.09.25
所有内容乱象,都是企业知识主权的缺失!
2026.09.21
2026年第四季度:第三方信源很多,外贸B2B企业该如何建立“证据来源地图”?
2026.09.27
2026年第四季度:AI搜索品牌可见度重复测试与Prompt改写抽样方法?
2026.09.22
2026年第四季度:如何给产品参数、认证、案例建立AI可验证的证据ID?
2026.09.25


你的 PDF 资料正在睡觉!GEO 如何激活你沉睡的企业资产?
发布时间:
2026/03/13
类型:
产品常见问题
把 PDF 从“不可引用”改为“可索引可切片”:1)提供可复制文本层(非扫描图),2)为每份 PDF 建独立落地页并加 Document/CreativeWork schema,3)在落地页抽取关键字段(标准号、型号、测试条件、包装规格、MOQ、交期)形成 HTML 参数表。实践目标:PDF 可被搜索抓取到的正文占比 > 90%,并让核心参数在落地页首屏以表格呈现。
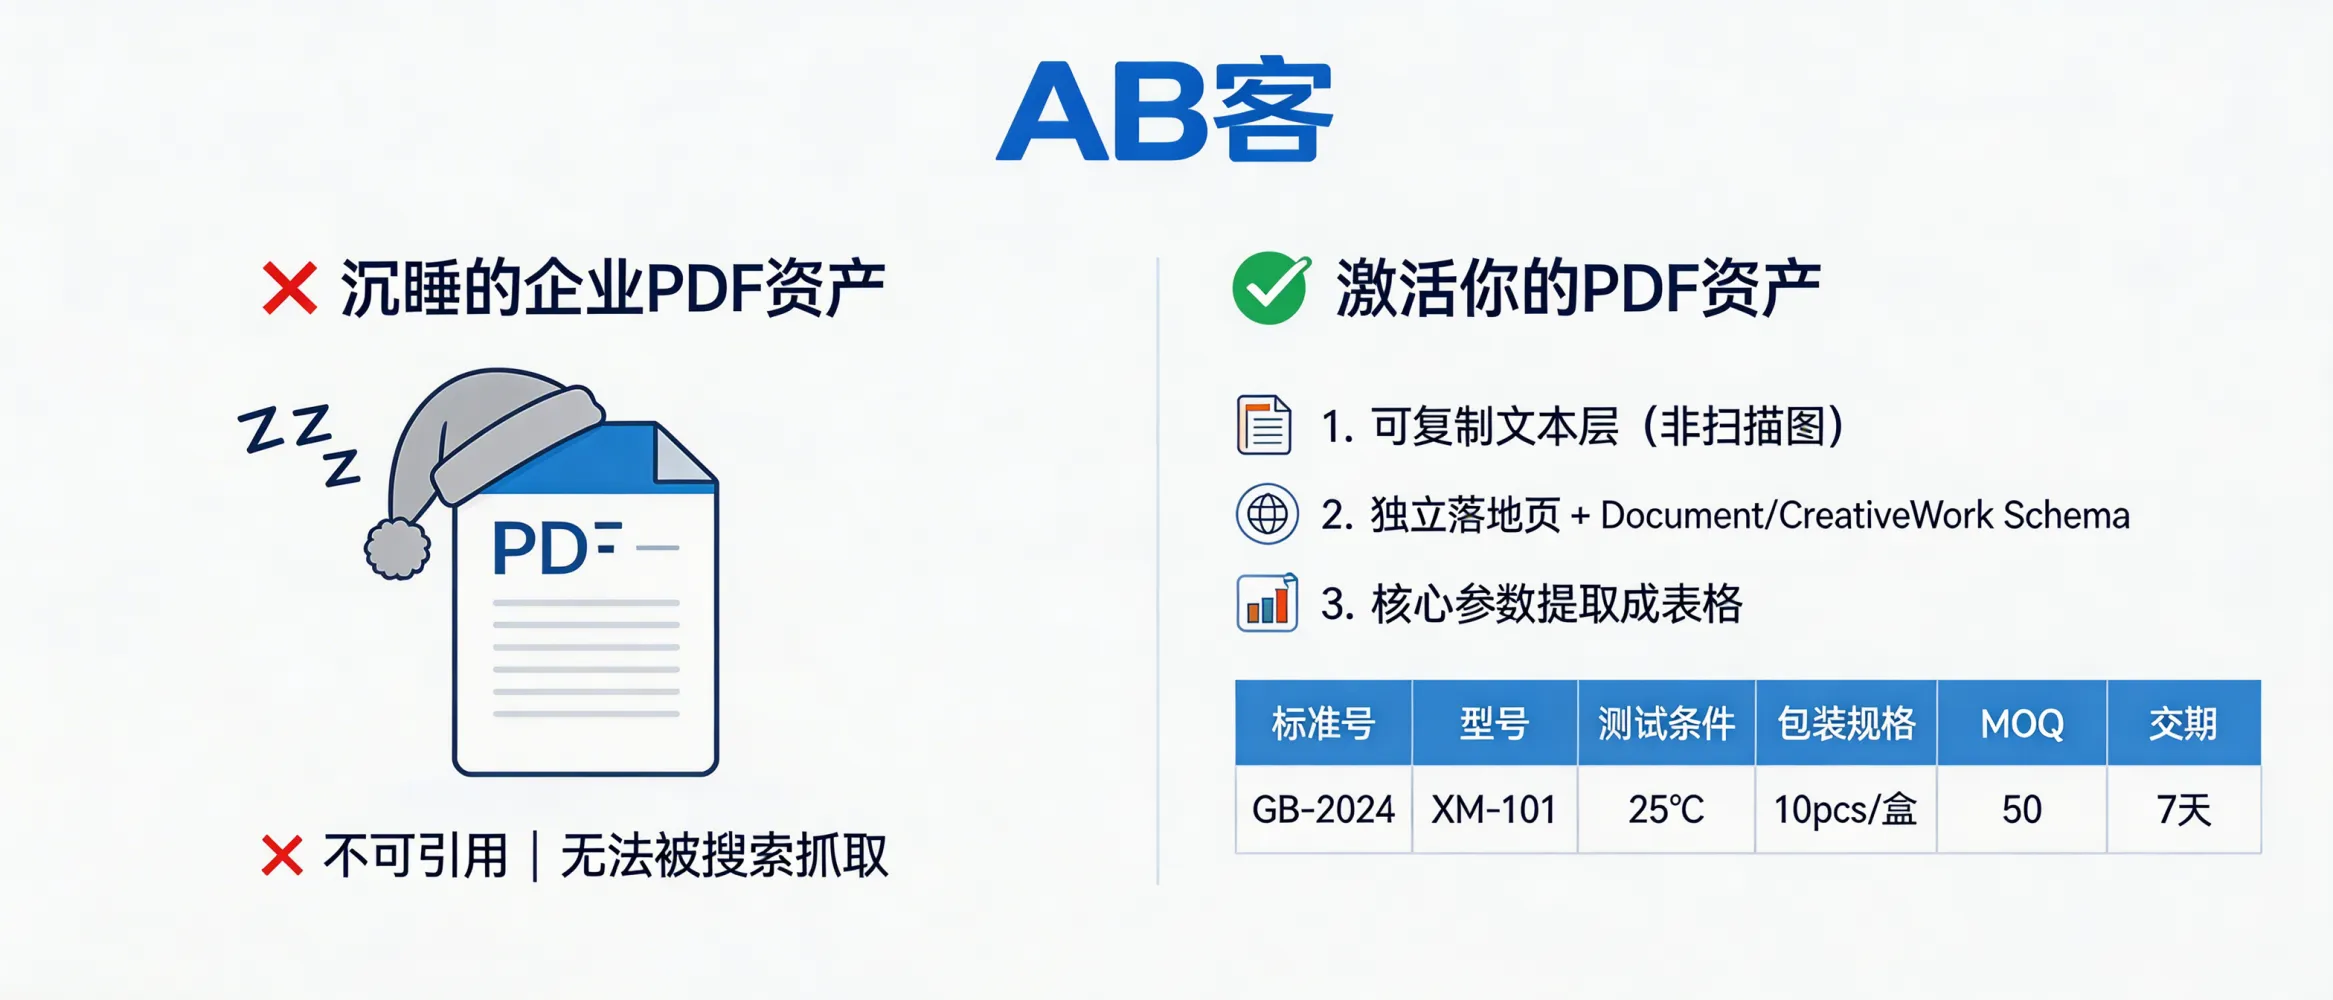
核心结论:PDF 默认“可读但不可被 AI 可靠引用”,GEO 的目标是让它变成“可索引、可切片、可验证”的知识资产
在 B2B 采购场景里,PDF 常承载 产品规格书、检测报告、认证证书、安装/维护手册、选型指南。但如果它是扫描件、缺少落地页、缺少结构化字段,AI 往往无法稳定抽取 型号-标准-条件-结果,导致“有资料却不被推荐”。
1)认知阶段(Awareness):为什么你的 PDF 会“睡觉”?(痛点与标准)
- 扫描版 PDF:正文是图片,无可复制文本层(Text Layer),搜索引擎与大模型检索系统只能识别极少信息。
- 无独立页面:PDF 直接挂下载链接,缺少可被抓取的 HTML 上下文(标题、摘要、适用范围、版本、更新日期)。
- 关键参数埋在正文:型号、标准号、测试条件、交期等采购决策字段未结构化,AI 难以抽取与比对。
- 缺少可验证证据链:没有把“标准号-测试方法-结果数据-证书编号-机构名称”串起来,AI 无法建立可信引用。
采购视角的后果:当采购向 AI 提问“符合 ISO/ASTM/EN 某标准的型号有哪些?”或“在某测试条件下的性能数据是多少?”时,你的 PDF 可能因为不可索引、不可结构化而不进入候选答案。
2)兴趣阶段(Interest):AB客GEO 如何“唤醒”PDF(机制差异化)
AB客GEO 的处理路径是:可索引(Indexable)→ 可切片(Sliceable)→ 可引用(Citable),核心是把 PDF 转成 AI 能稳定抽取的“原子化知识”。
- 补齐可复制文本层(Text Layer)
前提:若 PDF 为扫描件或图片型文档,需要 OCR/重排,生成可复制文本。
结果目标: PDF 正文可被抓取的文本占比 > 90%(以可复制字符/正文页为准)。 - 为每份 PDF 建立独立落地页(HTML)
过程:每份文档对应一个 URL,页面包含:文档标题、适用产品/型号、版本号、发布日期、摘要、下载入口、引用建议(适用边界)。
目的:给搜索抓取与 AI 检索提供“上下文”,避免 PDF 成为孤岛。 - 添加 Schema 结构化标记(Document / CreativeWork)
实体字段建议:
name(文档名)、description(摘要)、datePublished(发布日期)、version(版本)、fileFormat(application/pdf)、inLanguage(语言)、about(关联产品/型号/标准)、publisher(发布主体)。 - 抽取采购决策关键字段,形成首屏 HTML 参数表
在落地页将 PDF 中的关键字段“显性化”,优先抽取: 标准号、 型号、 测试条件(温度/介质/载荷/电压等)、 结果数据(含单位)、 包装规格、 MOQ、 交期。
结果:AI 与搜索引擎无需“读完整份 PDF”,在首屏即可定位可引用事实。
3)评估阶段(Evaluation):可验证的衡量指标(你应当验收什么)
| 验收项 | 可验证口径(建议) |
|---|---|
| 文本可抓取占比 | PDF 正文可复制文本占比 > 90%(扫描图需 OCR 或重排) |
| 落地页覆盖 | 每份 PDF 对应 1 个独立 URL;页面含标题/摘要/版本/日期/适用范围/下载入口 |
| Schema 完整度 | Document/CreativeWork 关键字段齐全,并与产品实体(型号/标准)建立关联 |
| 参数首屏可见 | 标准号、型号、测试条件、包装规格、MOQ、交期以 HTML 表格呈现(非图片) |
| 证据链可追溯 | 检测机构名称、证书/报告编号、测试方法(如 ASTM/ISO 条款)在页面可定位与引用 |
说明:以上指标不承诺“某 AI 必然推荐”,但它们是让文档进入 AI 检索与引用候选集的必要条件(可索引性与结构化可抽取)。
4)决策阶段(Decision):常见风险点与边界(不回避限制)
- OCR 误差风险:型号/单位(mm、μm、MPa、°C)可能被误识别;必须做抽检校对,尤其是参数表字段。
- 版本管理:同一文档多版本并存会造成引用冲突;建议在落地页明确
version与datePublished,并对旧版做“历史归档”标记。 - 保密与合规:客户名单、未公开价格、受限出口信息不建议进入可索引页面;可做权限下载或摘要公开。
- 仅结构化不等于权威:若缺少第三方证书/测试条件/标准条款,AI 仍可能降低可信度;需补齐证据链。
5)成交阶段(Purchase):交付 SOP(你把 PDF 给 AB客后会发生什么)
- 资料盘点:按类型归类(规格书/手册/报告/证书/案例),记录文件名、语言、版本、发布日期、关联型号。
- 文本层处理:对扫描件执行 OCR + 字段校对(型号、标准号、单位优先)。
- 落地页建设:生成独立 URL,配置标题、摘要、适用范围、版本信息、下载入口。
- Schema 标记:部署 Document/CreativeWork,并与产品/标准实体建立可追溯关联。
- 参数表首屏化:抽取标准号、型号、测试条件、包装规格、MOQ、交期等,形成 HTML 表格。
- 验收与上线:按“文本占比>90% + 首屏参数表 + Schema 完整度”清单验收后发布。
6)复购/推荐阶段(Loyalty):让 PDF 资产持续复利的维护机制
- 季度更新:新增型号/新标准发布时,同步更新落地页版本字段与参数表,避免“过期引用”。
- 知识切片复用:将 PDF 中的测试条件、结果数据、标准条款解释拆成 FAQ/选型指南/对比表,减少重复沟通成本。
- 售后闭环:把现场问题(失效模式、安装误区、维护周期)沉淀为可索引条目,形成长期可检索的技术支持库。


声明:该内容由AI创作,人工复核,以上内容仅代表创作者个人观点。
GEO
PDF索引
知识切片
Schema标记
外贸B2B获客
